Nodo Digital Lab
Che cosa serve per te?
Il problema: un file Excel o CSV sporco non è solo brutto da vedere: zeri iniziali spariti dai codici, righe duplicate, la stessa chiave presente con valori diversi, celle vuote riempite «senza dire niente». La prossima volta che qualcuno usa quel file, le decisioni prese non si sanno più ricostruire.
Come si lavora qui:
- le regole (quale colonna è un codice, che cosa fare per duplicati e conflitti, cosa fare con le celle mancanti) vengono decise prima del lavoro;
- il file originale non viene toccato: la pulizia va in una cartella separata;
- le anomalie vengono separate e spiegate, riga per riga, non fuse in silenzio;
- le celle mancanti non vengono mai riempite con valori inventati;
- insieme al file pulito ricevi un riepilogo che documenta le operazioni, con conteggi e l'hash SHA-256 dei file consegnati.
Esempi (dati dichiaratamente sintetici)
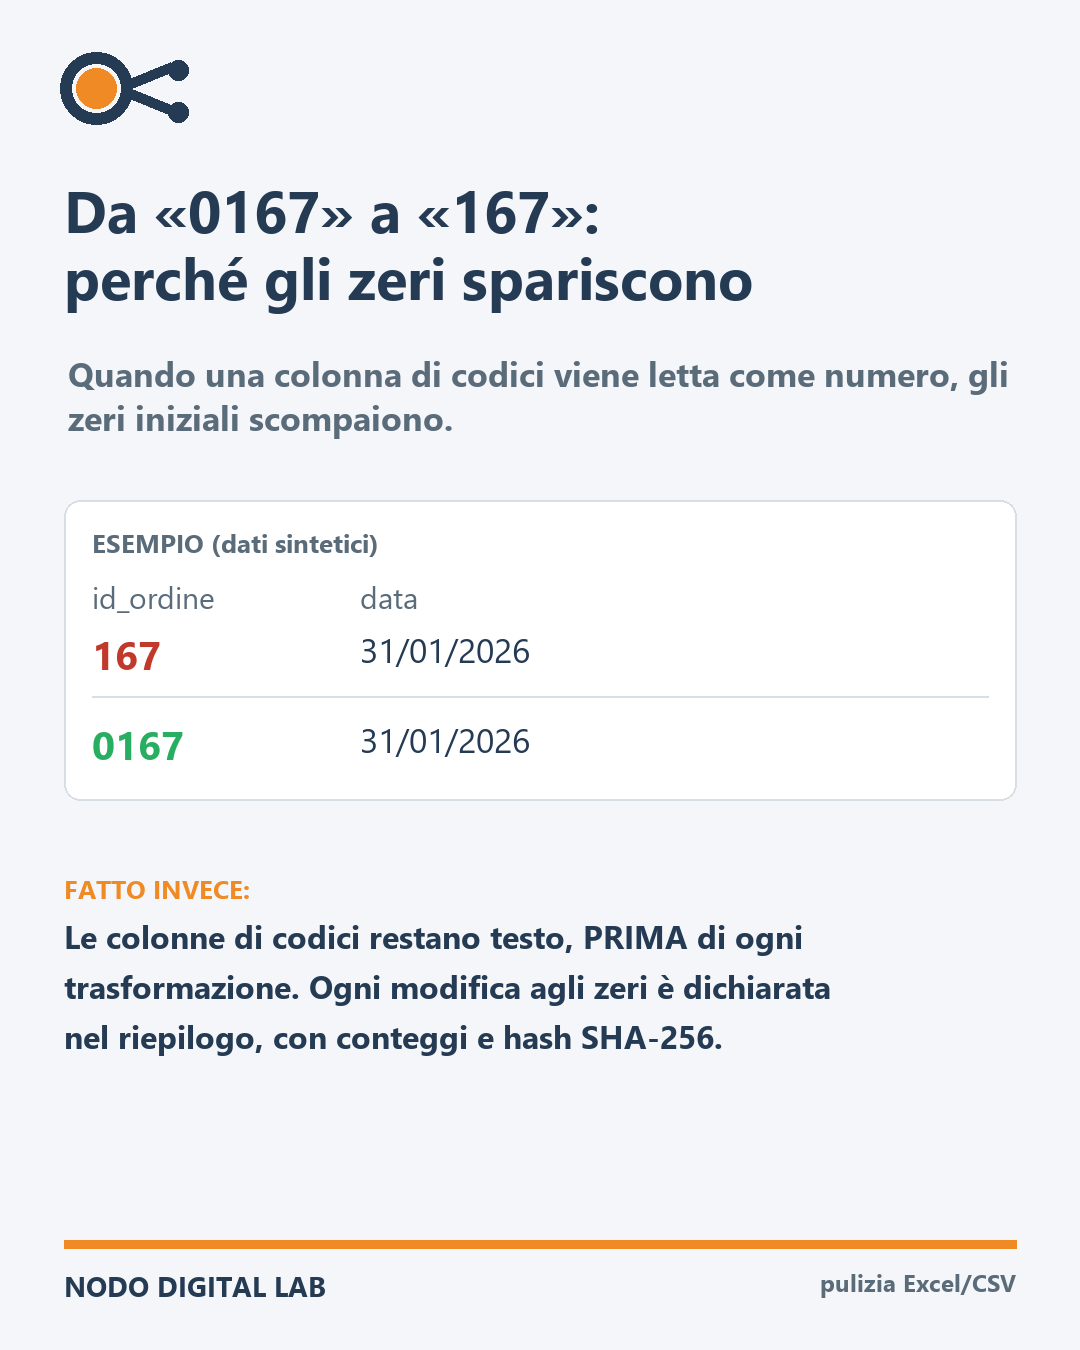
Zeri iniziali preservati
«0167» resta «0167»: una regola dichiarata prima, non un'opzione casuale.immagine m01
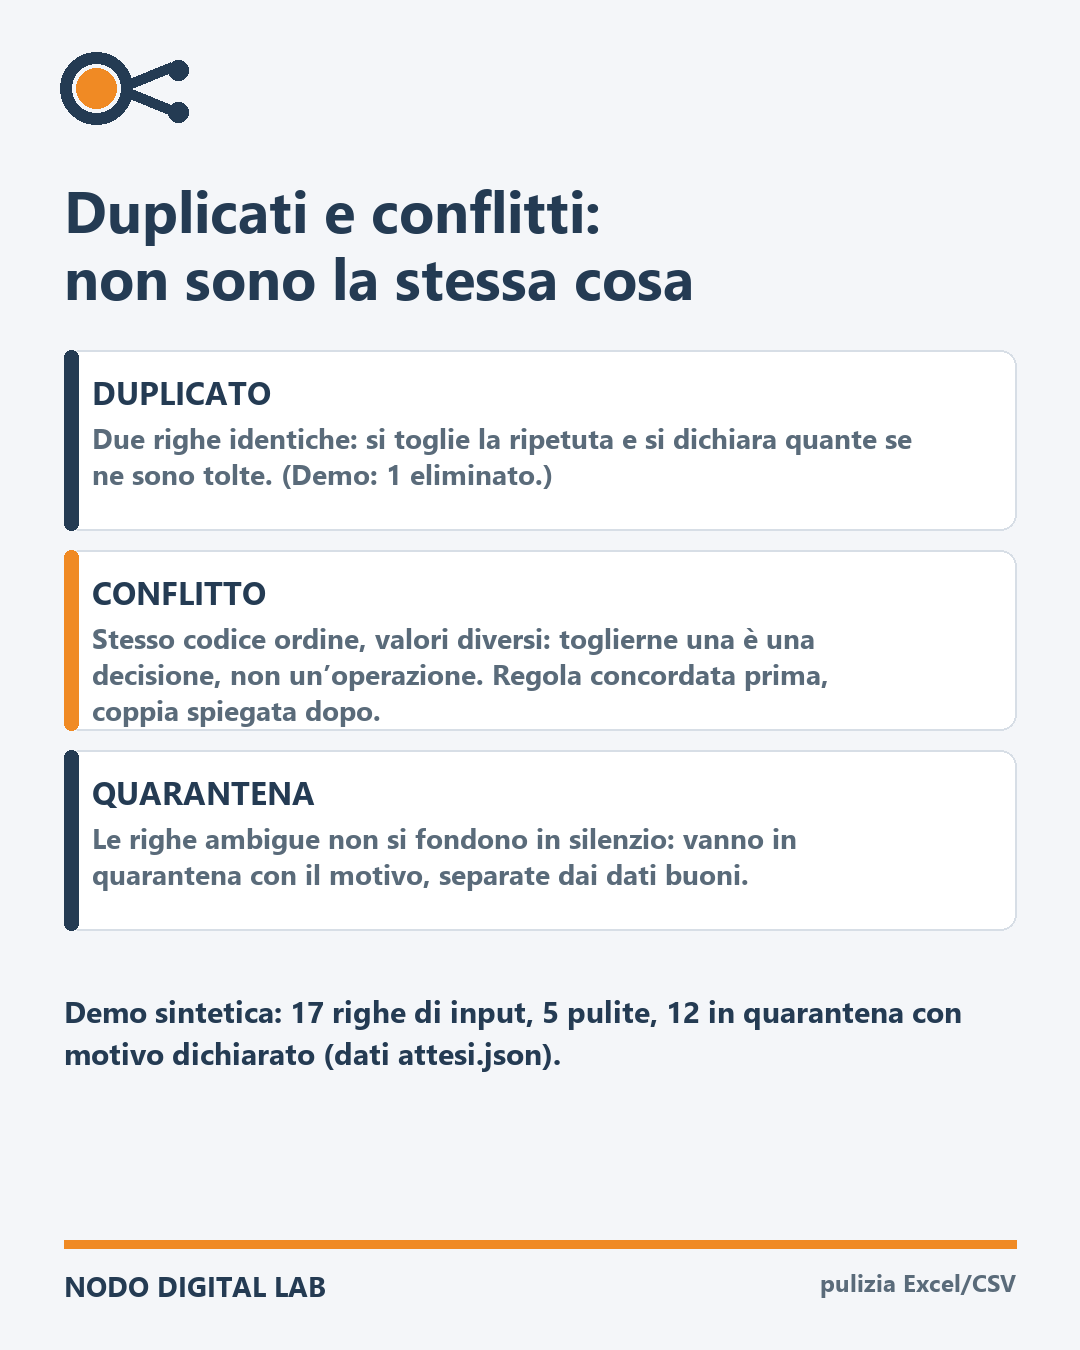
Duplicati vs conflitti
Due contatori distinti: righe eliminate e righe in quarantena, con motivo.immagine m02
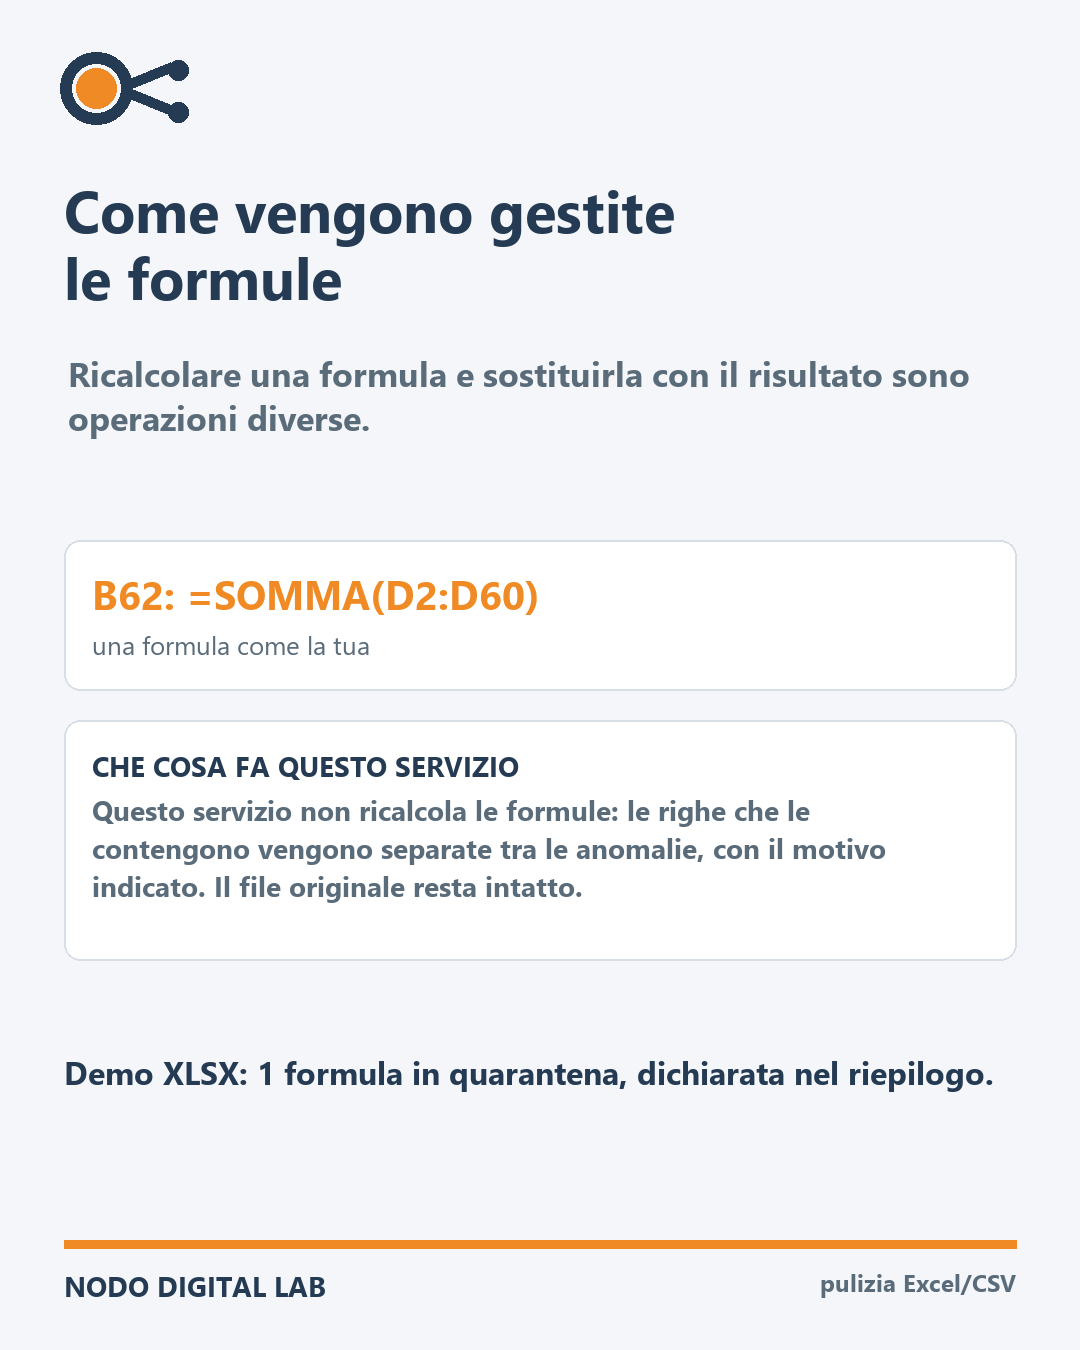
Formule non ricalcolate
Questo servizio non ricalcola le formule: le righe che le contengono vanno tra le anomalie, con il motivo; il file originale resta intatto.immagine m03
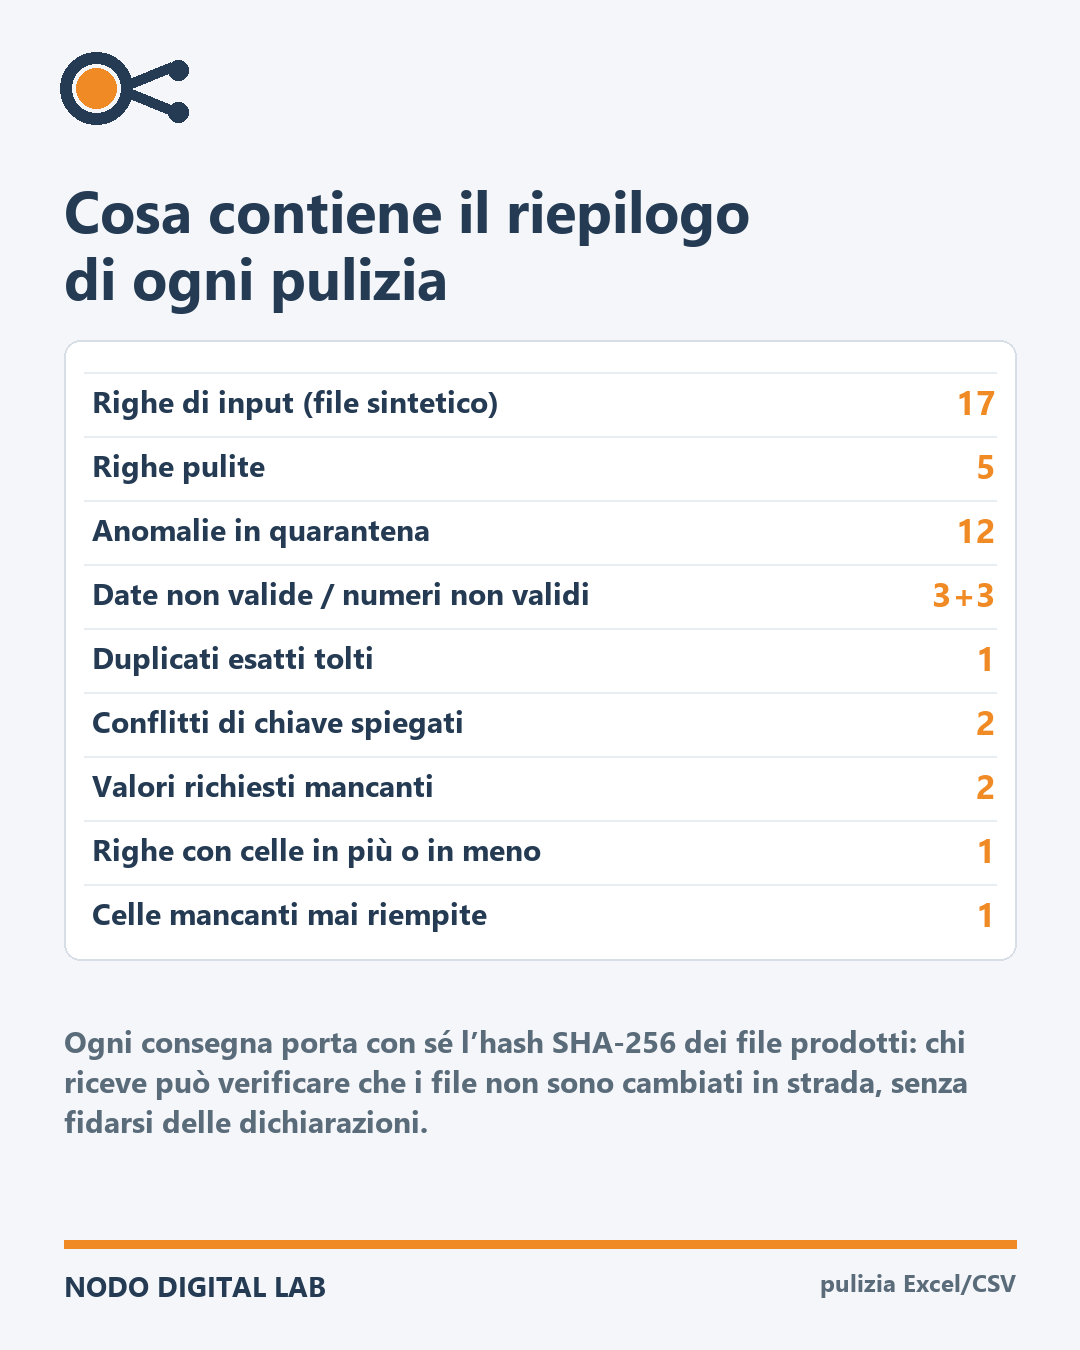
Riepilogo con conteggi
Quante righe pulite, quante anomalie, con quale motivo: numeri, non promesse.immagine m04
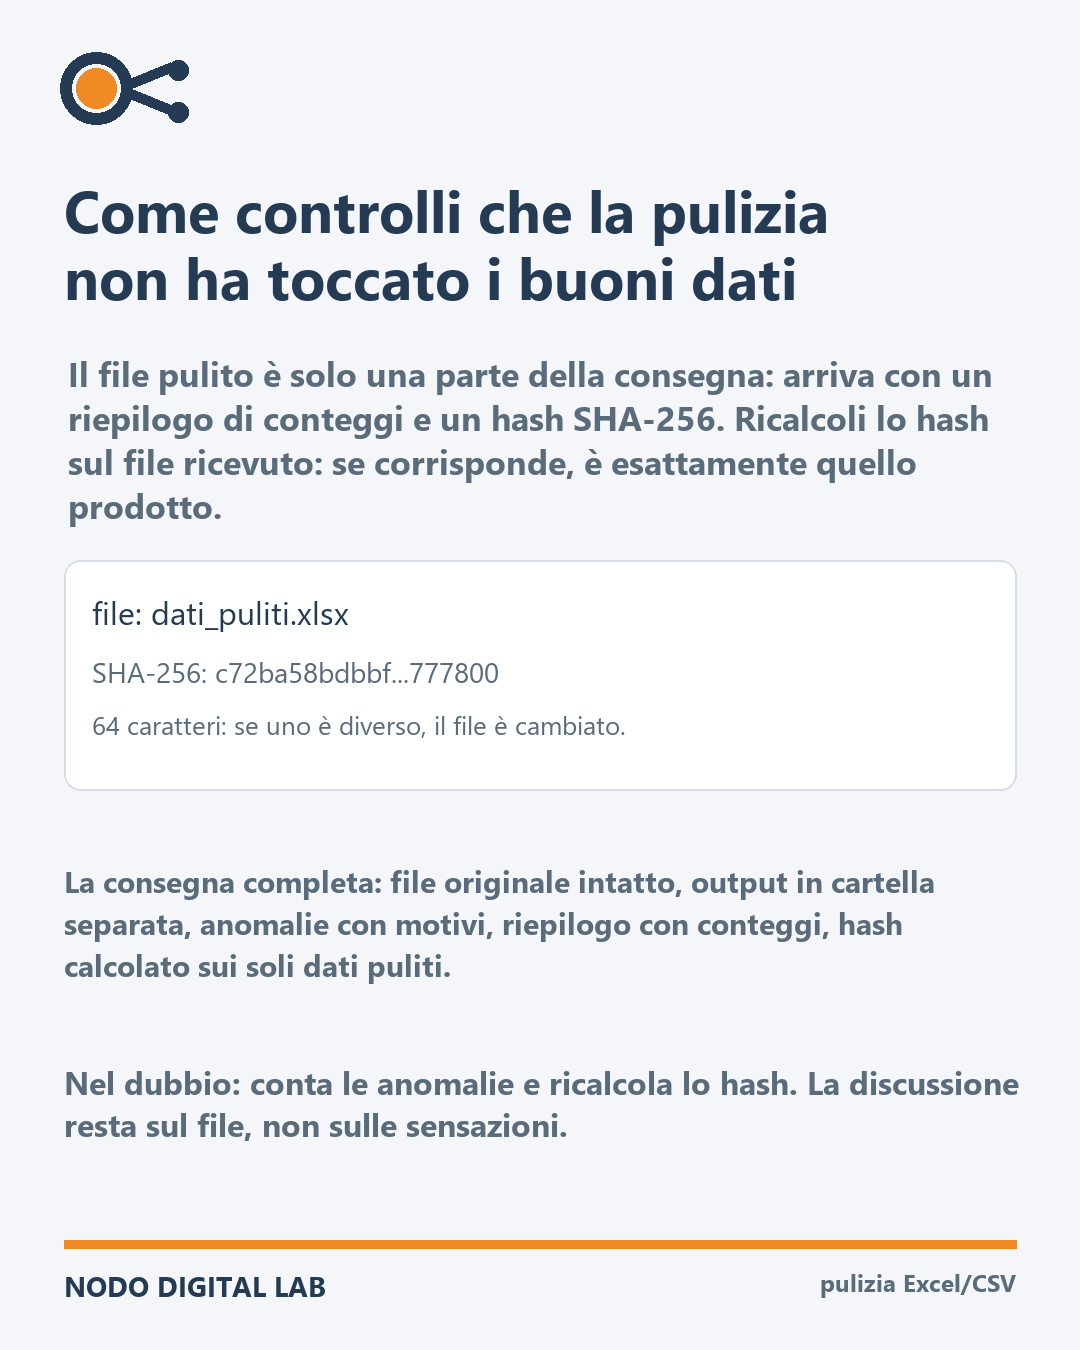
Consegna verificabile
Ogni file consegnato ha la sua impronta SHA-256: il controllo è tuo.immagine m05
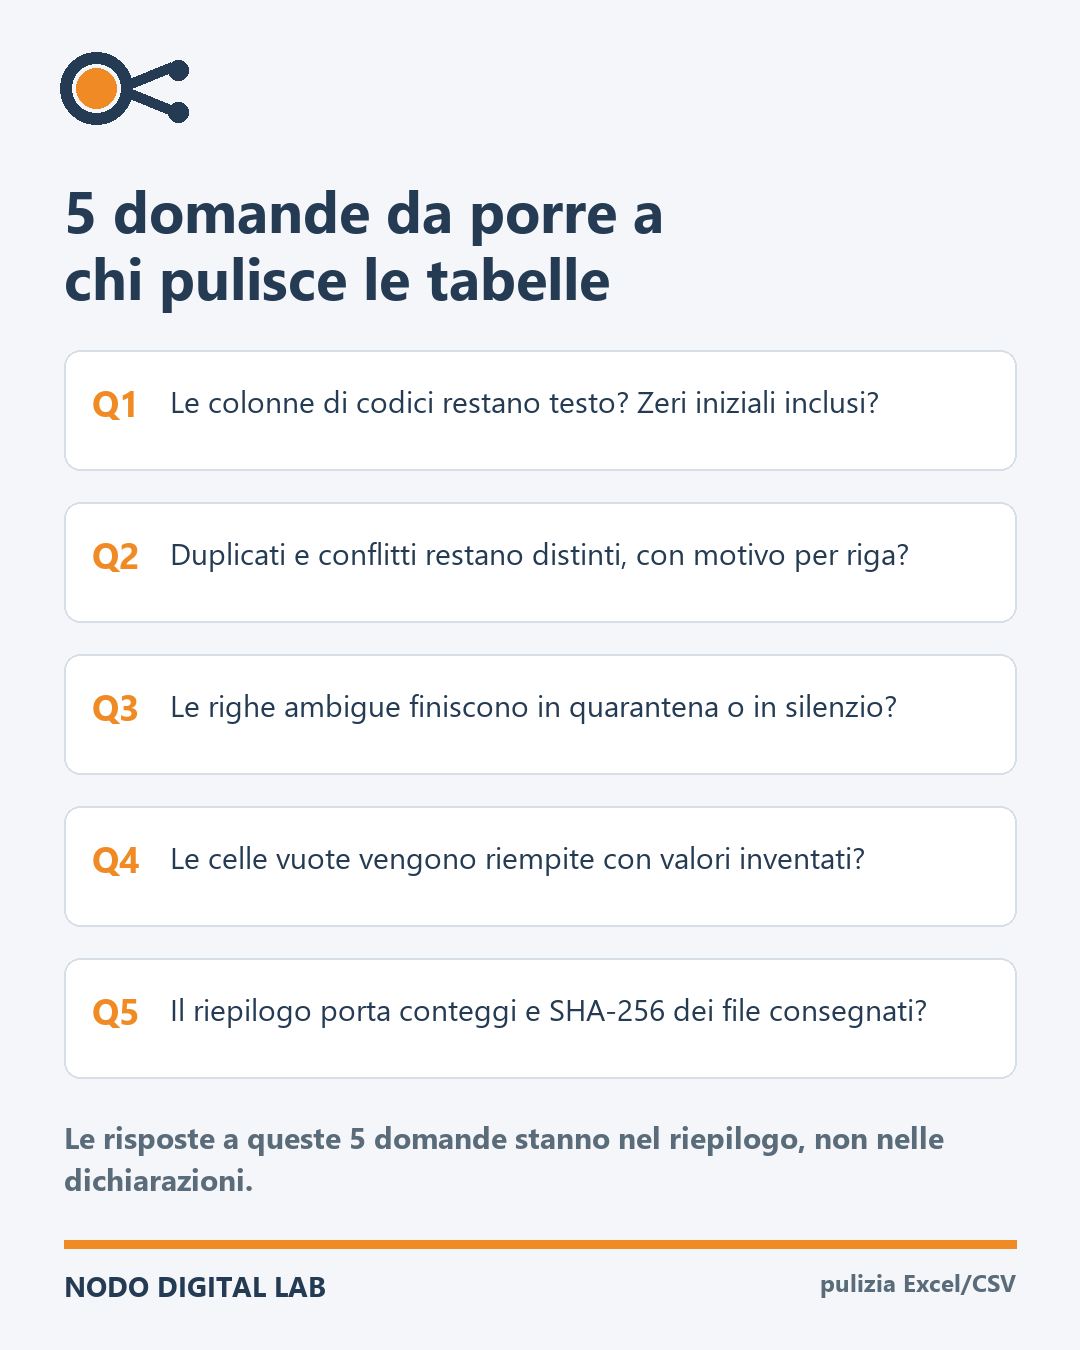
Cinque domande utili
Le domande giuste da fare a chiunque ti pulisca le tabelle: anche a questo progetto.immagine m06
Gli esempi qui sopra usano un piccolo dataset sintetico creato apposta per la demo (17 righe di esempio): nessun file di clienti. Il servizio è stato provato, sempre su dati sintetici, anche su file molto più grandi: fino a 20.000 righe per 6 colonne. Le formule presenti nell'input non vengono ricalcolate: le righe che le contengono vengono separate tra le anomalie, con il motivo. Niente macro, niente file cifrati elaborati. Il riepilogo documenta le operazioni e aiuta a controllare i risultati rispetto alle regole concordate; conteggi e hash non garantiscono da soli la correttezza dei dati. SHA-256 permette di confrontare l'integrità del file ricevuto con l'impronta di riferimento.
Dove trovi lo studio
- Instagram @nododigitallab — profilo ufficiale dello studio
- Pinterest @nododigitallab — bacheca con gli esempi
Chiedere un campione dimostrativo
Descrivi il tuo dataset e chiedi il campione dimostrativo nododigitallab@gmail.comSe il click non apre l'email: scrivi con Gmail.